同じASINで価格差を見つけても、それだけで仕入れ機会や競合の値下げと判断するのは早計です。Amazon.co.jp 出品価格データ連携の目的は、公開されているオファーを一つの最安値に押し込めることではありません。出品者ごとの価格、送料の表示、商品の状態、フルフィルメント、配送に関する文言、取得時刻を、検証可能な観測レコードとして残すことです。そうすれば、バイヤーは調達候補を比較する前に条件差を確認でき、販売側は同等でない競合オファーに反応してしまうリスクを減らせます。
ここで扱うのは、公開ページまたは収集結果に表れた一時点の情報です。価格表示は取得後に変わることがあり、送料や配送条件はオファーごとに異なる場合があります。また、公開スナップショットから販売数、将来の在庫、税額、利益率、実際の配送結果を断定することはできません。だからこそ、データ連携では「何を、どの市場で、いつ見たか」を商品や数値と同じ重さで保持します。観測事実と社内の判断ルールを分ける設計が、後から説明できる比較の出発点になります。
最初に決めるべきこと:最安値フィードではなく、オファー観測の集合を作る
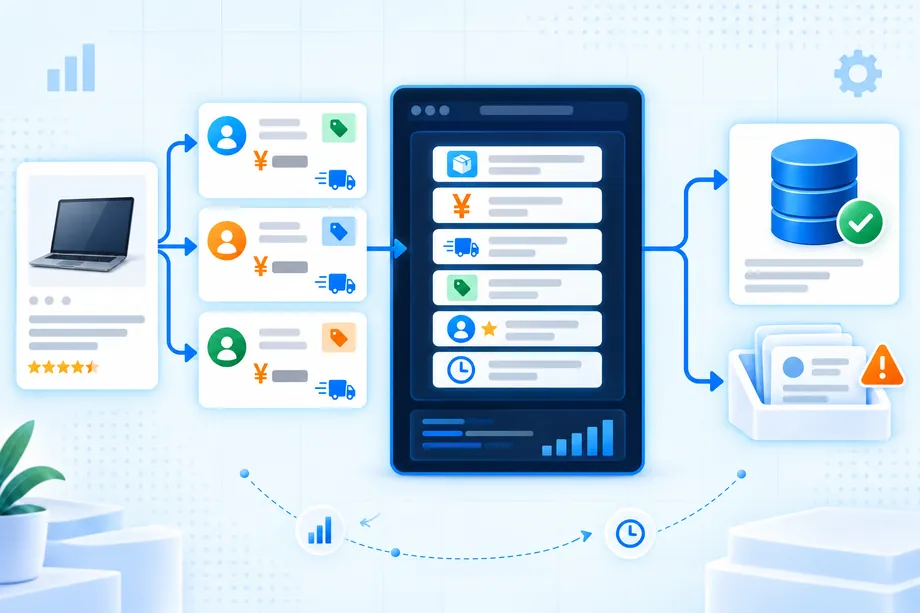
基本単位は、商品一件ではなく「あるASINに紐づく、ある出品者の、ある時点のオファー」です。ASINは商品を結び付ける共通キーとして有効ですが、同じASINであればすべての出品条件が等しい、という意味ではありません。新品と中古、配送元やフルフィルメントの違い、送料の有無、到着予定の表現などが異なれば、表示額が似ていても比較の意味は変わります。商品行とオファー行を分けるだけで、この違いをデータ上で見失いにくくなります。
開始時は、対象を意図的に小さくします。市場をAmazon.co.jpに固定し、対象ASIN、用途、対象に含める状態やオファー種別、除外条件を入力台帳に書きます。たとえば販売側なら自社カタログに対する公開競合条件の確認、バイヤーなら仕入れ調査の一材料としての公開条件の把握というように、同じASINでも問いを明確にします。親商品ではなくバリエーションを判断単位にするのか、状態が不明なものは比較から外すのかも、収集前に決めておくと後の集計がぶれません。
| データ層 | 保持するもの | 比較で防げる誤解 |
|---|---|---|
| 商品スコープ | ASIN、市場、商品名、ブランド、必要なバリエーション情報 | 別商品や別市場のレコードが混ざること |
| オファー観測 | 出品者ごとの公開条件と取得時刻 | 複数の条件を商品平均や最安値に潰すこと |
| 正規化 | 価格、送料、状態、フルフィルメントの対応付け | 文字列の違いだけで比較不能になること |
| 検証状態 | 受理、不完全、重複候補、確認待ちの理由 | 欠損や矛盾を正常値として扱うこと |
Amazon.co.jp 出品価格データ連携は、商品情報とオファー情報を分けて扱う
商品詳細のスナップショットは、商品名、ブランド、画像、商品ページ上の価格表示、在庫に関する表示など、共有の商品文脈を確認するのに役立ちます。一方、オファースナップショットが答えるのは、指定ASINに対してその時点でどの公開オファーが見え、各オファーにどの条件が表示されているかです。この二つはつながっていますが、商品ページ上の一つの価格を、出品者ごとの条件を伴うオファー価格の代用にしてはいけません。
同一ASINの公開オファーを扱うときは、Easyparserのオファー取得API(Product Offer)のように、ASINに対するオファー水準の情報を取得する操作を商品詳細とは別に位置付けます。公開ドキュメントで説明される範囲では、この操作はアクティブな出品者オファー、価格または割引、出品者情報と評価、フルフィルメント種別、Buy Boxの所有状況、注文数量制限を対象にし、リアルタイムとBulkで利用できます。受け取った値は、その時点の観測として扱い、非公開の販売者アカウント情報や確定在庫を示すものとして拡張解釈しません。
商品側の共通文脈が必要な場合は、商品詳細取得(Product Detail)を別の入力として使えます。商品名、ブランド、画像、価格、在庫に関する表示などを、オファーレコードに直接上書きせず、商品スナップショットとして保管します。こうしておけば、表示額の変化が出品条件の変化なのか、商品側の表示の変化なのか、あるいは双方なのかを、時刻とレスポンス種別に沿って確認できます。
比較可能な最小スキーマを先に定義する
データを受け取ってから列を考えると、表示名が変わったときや欠損が出たときに、集計ルールが人によって異なります。先に商品スナップショット、オファースナップショット、実行記録という三層の役割を定義します。以下はアプリケーション側で管理するための例示的なスキーマです。これは特定の提供元レスポンスの項目名を表すものではなく、受信した公開情報をどう保存・検証するかの設計例です。
| 項目 | 例示的な値 | 設計上の扱い |
|---|---|---|
| marketplace | amazon.co.jp | 入力時に固定し、別市場の値との混在を禁止する |
| asin | B0XXXXXXXX | 要求時のASINと観測側のASINを照合する |
| observed_at | 2026-10-26T09:15:00+09:00 | 実際に観測した時刻。予定時刻とは別に保存する |
| seller_label_raw | 公開画面に表示された名称 | 空欄を別の実行回の名称で補わない |
| condition_raw / condition_normalized | 表示値 / new、used、unknown | 元表記を残し、対応規則を明文化する |
| item_price_jpy / shipping_jpy | 数値またはnull | 解析根拠がある額だけ数値化し、欠損をゼロにしない |
| fulfillment_raw / delivery_raw | 公開表示の原文 | 配送や履行の文言は価格から分離して残す |
| source_reference | 内部の元レスポンス参照 | 確認時に原値と対応付けられるようにする |
| quality_state | accepted、incomplete、review_needed | 比較可能性を一目で判定できるようにする |
この表で重要なのは、正規化列だけでなく原値列と出所を持つことです。たとえば価格表示を数値化できたとしても、その表示が商品代金だけなのか、送料を含む合計として読めるのかは、入力の表現と社内ルールに依存します。そこでitem_price_jpyとshipping_jpyを別にし、合計相当額を使う場合は、どの成分が揃ったときに計算を許可するかを定義します。送料が未表示なら、合計を推定せず、比較対象外または確認待ちにします。
同様に、取得日時は単なる監査列ではありません。09時の価格と15時の価格を同じ行で置き換えると、変化の理由が追えなくなります。履歴を保持するテーブルでは、observed_at、実行ID、入力ASIN、元レスポンス参照を不可分の組として保存します。日次レポートに最新値だけを出す場合でも、下流の表示は履歴から作るようにすれば、誤った変換や一時的な欠損を後から再検証できます。
JPY価格、送料、状態、配送を一つの数値に混ぜない
日本円の表示価格は比較の中心になりますが、単独では商取引上の意味が足りません。公開情報の範囲で確認できるなら、商品代金の表示、送料の表示、状態、フルフィルメント種別、配送に関する文言、出品者表示を別々の列に入れます。たとえば商品代金が低くても送料が不明なら、同額の送料無料オファーと同じ順位に置く根拠はありません。逆に、表示額が高くても状態や配送条件が異なれば、単純な差額だけで優劣を決められません。
正規化ルールは、値を増やすためではなく、比較の可否を明らかにするために使います。状態の元表記をcondition_rawに残し、明確に対応できる場合だけnewやusedなどの管理語彙へ写します。判断できない表現はunknownにします。フルフィルメントと配送についても、元の文言と、必要であれば自社で定義した分類を並べます。この方法なら、分類規則を変えたときに過去の原値から再処理できます。
バイヤーは、この分離によって公開オファーを仕入れ可否の結論ではなく、追加確認が必要な市場条件として扱えます。販売側は、自社オファーと比較する候補を条件別に絞り込めます。どちらの場合も、公開表示から税、手数料、販売実績、実際の利益、在庫の確実性を導くことはしません。価格列の横に、欠損の理由と取得時刻を表示するだけでも、数字だけが独り歩きすることを抑えられます。
出品者とオファーの対応付けは、原値を残して行う
同一ASINの複数行を扱うとき、商品キーだけで重複排除すると、異なる出品者の条件が失われます。実務では、marketplace、asin、利用可能な出品者識別子または表示名、状態、フルフィルメント、観測時刻または観測窓を組み合わせ、同一観測候補を判定します。ただし、表示名だけで同一事業者と断定できない場合があります。識別子がないなら、重複削除を強くかけ過ぎず、類似候補として確認キューに送る方が安全です。
たとえば、同じASINで同じ出品者表示が二行あり、状態と履行の表示も一致し、同じ実行IDと短い観測窓に含まれるなら、アプリケーション側の重複候補として扱えます。一方、価格だけが異なる、配送文言が異なる、取得時刻が大きく離れている場合は、安易に一方を消してはいけません。値の変化なのか、別の条件なのか、収集上の重複なのかを、人が元値と時刻を見て判断できる状態に残します。
追加の公開出品者文脈が必要なときは、出品者プロフィール取得(Seller Profile)を、オファー取得とは別の補足工程にします。補足情報にも取得時刻を付け、後日取得したプロフィール情報を、過去のオファーに当時存在した事実のように結合しないことが大切です。オファーと出品者情報の時点を分ければ、どちらが古いのか、どちらが未取得なのかをレビューで判断できます。
小規模パイロットでマッピングと例外を先に確かめる
本格運用の前に、少数のASINで小規模パイロットを行います。対象は、出品者が複数見える商品、状態や配送表示に違いがありそうな商品、比較的安定した商品を混ぜると、正規化規則の弱点を見つけやすくなります。各ASINについて、入力台帳、商品スナップショット、オファースナップショット、保存後の正規化行を並べ、想定した列に必要な情報が入るかを確認します。この確認は将来の全レコードの完全性を保証するものではありませんが、前提の誤りを低コストで発見できます。
パイロットでは、少なくとも次の問いに答えられるようにします。要求した市場は常にAmazon.co.jpとして記録されるか。ASINは入力値と照合できるか。価格と送料を別列に保存できるか。状態、フルフィルメント、配送、出品者のいずれかが欠けたとき、欠損理由を残せるか。元レスポンスを参照できるか。そして、同じ実行を再処理しても、同じ観測が二重に増えないかです。答えが曖昧な箇所は、スケジュールを速くする前にマッピングを修正します。
レビュー対象の選び方も、パイロットで具体化します。たとえば、出品者表示がない、商品代金の数値化ができない、送料が比較ルール上必須なのに未表示、状態が管理語彙に対応しない、ASINの照合に失敗した、といった条件をreview_neededにします。単にエラー件数を数えるのではなく、どの例外がビジネス上の比較を止めるのかを分類すると、バイヤーと販売側で共有するデータ品質の境界が明確になります。
収集単位、実行記録、更新頻度を結び付ける
一件を確認する対話的な調査と、カタログを定期更新する処理は同じ運用ではありません。一つの現在の照会をすぐ確認したいパイロットや例外対応ではリアルタイム収集が適します。多数のASINを更新し、処理後に結果を受け取れる定期処理ではBulk収集を検討できます。どちらでも、アプリケーション側では実行ID、対象ASIN数、入力台帳の版、選んだ操作、市場、送信時刻、完了時刻、結果状態を実行記録に残します。
更新頻度は「できるだけ短く」ではなく、意思決定の期限、観測された変動、確認できる例外数で決めます。たとえば週次のカテゴリ確認なら、日中の細かな変動を追うためだけに高頻度化しても、レビューが追い付かなければ比較品質は上がりません。まず人が例外を読める頻度で開始し、変更件数、欠損率、確認に要する時間を測ります。その後、対象カテゴリや利用目的ごとに頻度を見直します。
定期的なAmazon.co.jp 出品価格データ連携では、予定された実行時刻と実際のobserved_atを別にします。キューの遅延や再試行があれば、予定どおりに開始したとしても、観測された市場状態は後の時点のものかもしれません。日付だけではなくタイムゾーンを含む時刻を保管し、レポートで「いつの比較か」を示します。これにより、バイヤーは古い観測に基づく調査を区別でき、販売側は価格変化の検討時に時点のずれを把握できます。
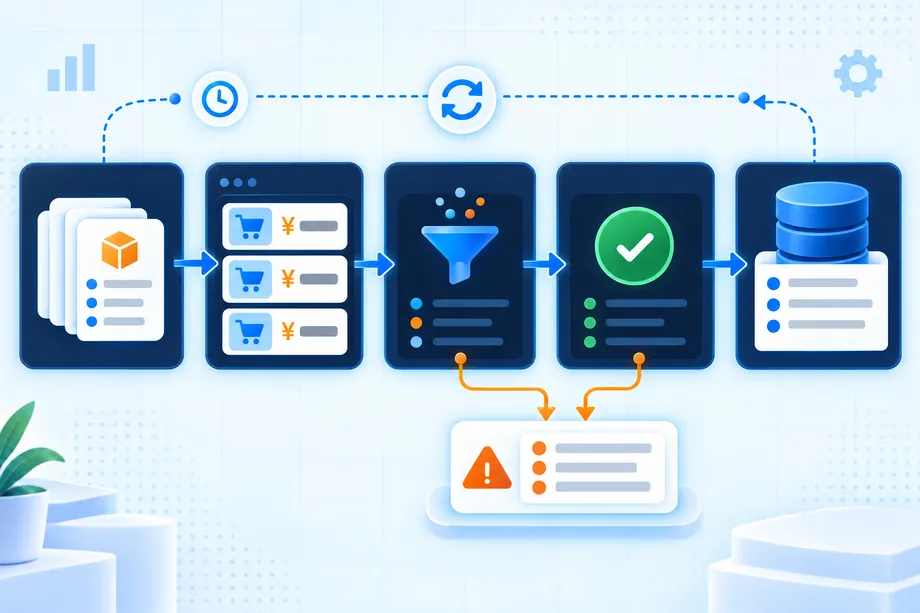
入力マニフェストも実行記録の一部にします。各回で、要求したASIN、使用可能なデータが返ったASIN、検証に失敗したASIN、再試行候補、レビュー対象を列挙します。成功した行だけを保存して終えると、レポートの母数が静かに変わり、価格差が市場の変化なのかデータ欠損なのかを判断できません。入力と出力の差分を持つことが、定期処理を分析用の証跡に変えます。
Python実装例:単一ASINの照会からBulk収集へ
以下は、Amazon.co.jpを指定してOFFERを呼び出し、比較前の原データを保存する最小例です。Python環境にpython -m pip install requestsで依存ライブラリを入れ、APIキーをEASYPARSER_API_KEY、日本市場で確認したASINをAMAZON_JP_ASINに設定してください。キーはサーバー側の環境変数で管理し、公開ページやコードへ埋め込まないでください。例の時刻はクライアントの受信時刻であり、提供元の取得時刻と同一とは限りません。返却された時刻情報があれば別に保存します。
1. Real-Time APIでオファーを照会し、原値を保存する
リアルタイムではGETのクエリにapi_keyを渡し、domainは.co.jp、operationはOFFERとします。この例はmin_page=1、max_page=1の一ページだけを対象とし、全オファーの網羅を保証しません。ページ数を増やす場合は上限とページ単位のクレジット消費を確認します。
import json
import os
from datetime import datetime, timezone
from pathlib import Path
from uuid import uuid4
import requests
# 実際のAPIキーとAmazon.co.jpで確認したASINを環境変数に設定します
asin = os.environ["AMAZON_JP_ASIN"]
params = {
"api_key": os.environ["EASYPARSER_API_KEY"],
"platform": "AMZ",
"operation": "OFFER",
"domain": ".co.jp",
"asin": asin,
"min_page": 1,
"max_page": 1,
}
response = requests.get(
"https://realtime.easyparser.com/v1/request",
params=params, timeout=90,
)
if not 200 <= response.status_code < 300:
raise RuntimeError(f"HTTP {response.status_code}")
raw = response.json()
if raw.get("success") is False:
raise RuntimeError("API処理に失敗しました。正規化を停止してください。")
snapshot = {
"marketplace": "amazon.co.jp",
"asin": asin,
"received_at": datetime.now(timezone.utc).isoformat(),
"raw_response": raw,
}
path = Path(f"offer-snapshot-{uuid4().hex}.json")
path.write_text(json.dumps(snapshot, ensure_ascii=False, indent=2), encoding="utf-8")
print(path)
保存するraw_responseはAPIの原応答で、marketplace、asin、received_atはアプリケーション側の管理項目です。応答構造を推測して価格列へ直結せず、小規模パイロットで実際のオファー配列と必要な項目を確認してから、前述のスキーマへ対応付けます。HTTP失敗やAPI失敗を価格ゼロに変換しないことも重要です。キーを含むリクエストURLや例外をログに残さないようにしてください。
2. Bulk APIへ複数ASINを送信し、受付結果を記録する
一括送信では、カンマ区切りの実ASINをAMAZON_JP_ASINS、稼働する自社HTTPS webhookをEASYPARSER_CALLBACK_URLに設定します。POSTの認証はクエリではなくapi-keyヘッダーです。requestsのjson=指定でJSON本体とContent-Typeが設定されます。入力は単数のasinではなく、payload.asinsの配列として送ります。バッチの5000件上限とは別に、契約プランの分間制限も守ってください。
import json
import os
from pathlib import Path
from uuid import uuid4
import requests
# カンマ区切りの実ASINと、稼働する自社HTTPS webhookを設定します
asins = [value.strip() for value in os.environ["AMAZON_JP_ASINS"].split(",") if value.strip()]
if not asins or len(asins) > 5000:
raise ValueError("ASINは1件以上、5000件以下にしてください。")
jobs = [{
"platform": "AMZ",
"operation": "OFFER",
"domain": ".co.jp",
"payload": {"asins": asins},
"callback_url": os.environ["EASYPARSER_CALLBACK_URL"],
}]
response = requests.post(
"https://bulk.easyparser.com/v1/bulk",
headers={"api-key": os.environ["EASYPARSER_API_KEY"]},
json=jobs, timeout=90,
)
if not 200 <= response.status_code < 300:
raise RuntimeError(f"HTTP {response.status_code}")
receipt = response.json()
path = Path(f"bulk-receipt-{uuid4().hex}.json")
path.write_text(json.dumps(receipt, ensure_ascii=False, indent=2), encoding="utf-8")
if receipt.get("success") is not True:
raise RuntimeError("送信に失敗しました。保存済みの受付結果を確認してください。")
data = receipt.get("data", {})
for group in data.get("accepted", []):
for result in group.get("results", []):
print(result["asin"], result["id"])
for name in ("invalid", "failed", "insufficient_credit", "rate_limit_exceeded"):
if data.get(name):
print(name, json.dumps(data[name], ensure_ascii=False))
print(path)
出力される個別のidは結果取得に使う識別子です。受付のsuccess=trueは全ASINの成功を意味せず、invalid、failed、insufficient_credit、rate_limit_exceededも確認します。受付結果は解析済みの価格データではありません。タイムアウトで受付状況が不明なときは、同じバッチを自動再送せず、既存の受付状況を確認して二重処理を避けます。
3. 完了通知後に個別の結果を取得する
webhookは完了と結果IDの通知であり、解析済みデータそのものを送るわけではありません。通知後、受付結果の個別IDをEASYPARSER_RESULT_IDへ設定し、次の例を別工程として実行します。バッチ全体の識別子ではなく、accepted内のresultsから得た個別IDを使ってください。
import json
import os
from pathlib import Path
from uuid import uuid4
import requests
# webhookの完了通知後に、受付結果の個別idを設定して実行します
result_id = os.environ["EASYPARSER_RESULT_ID"]
response = requests.get(
f"https://data.easyparser.com/v1/queries/{result_id}/results",
headers={"api-key": os.environ["EASYPARSER_API_KEY"]},
params={"format": "json"}, timeout=90,
)
if not 200 <= response.status_code < 300:
raise RuntimeError(f"HTTP {response.status_code}: 完了状態を確認してください。")
raw = response.json()
path = Path(f"bulk-result-{uuid4().hex}.json")
path.write_text(json.dumps(raw, ensure_ascii=False, indent=2), encoding="utf-8")
print(path)
まだ完了していない場合は、GET /v1/queries/{id}で状態を確認し、制限を守って結果取得を後の工程へ回します。保存した結果をASINと受付台帳に結び付け、送料、状態、出品者などの欠損を検証してから比較に使います。ここでは実行構造を示しており、このブログのためにライブAPIや日本市場の全項目をテストしたという意味ではありません。
検証では、欠損・重複・矛盾を削除せず可視化する
Amazon.co.jp 出品価格データ連携の品質は、見栄えのよい表よりも、疑わしい行を追跡できるかで決まります。各実行の終わりに、要求市場とASINの照合、最低必須項目の有無、価格の解析結果、重複候補、前回からの大きな表現変更を確認します。出品者、状態、送料、配送のいずれかがないこと自体は珍しくありません。問題は、それを完全な比較レコードのように見せてしまうことです。
品質状態は、単純でも運用できます。必要な照合と最小項目を満たしたものをaccepted、必須ではない項目が欠けたが保存価値のあるものをincomplete、比較や結合の前に人の判断が必要なものをreview_neededにします。さらに、状態の根拠をquality_reasonとして記録します。たとえばshipping_missing、seller_unavailable、ambiguous_price_text、asin_mismatch、duplicate_candidateのように分類すれば、例外の傾向を集計できます。
矛盾に見える値を見つけたら、最初に原値、元レスポンス参照、取得時刻、実行IDを照合します。後の実行で出品者名が変わっていても、それは修正すべき誤りではなく市場表示の変化かもしれません。逆に、同じ実行内で一つのオファーに複数の価格が現れるなら、比較を止めて確認する根拠になります。不明な値をゼロや空文字に置換したり、別実行の値で補完したりすると、正確そうに見える一方で再現性を失います。
入力マニフェストと処理境界を明文化する
定期処理の再現性は、結果だけでなく入力を再現できるかで決まります。各バッチには、要求したASINの一覧、Amazon.co.jpという市場指定、入力台帳の版、収集目的、提出時刻を含む入力マニフェストを付けます。ASINを後から入れ替えた場合も、元のマニフェストを更新して消すのではなく、変更した人、理由、変更時刻を別の記録に残します。これにより、ある日の比較表に含まれた商品と、含まれなかった商品を説明できます。
処理の境界も、収集前に決めます。たとえば、一つのバッチが数十件のASINを対象とするなら、どの時点で受付済み、処理中、取得完了、検証完了、部分失敗と判定するかを状態として定義します。結果が一部だけ返った場合に、成功分を公開しつつ失敗分をマニフェスト上で明示するのか、バッチ全体を保留するのかは、利用目的により異なります。重要なのは、欠けたASINを成功した行の陰に隠さないことです。
再試行にも識別子を与えます。一時的な取得不能が起きたとき、元の実行と同じ入力を再試行したのか、対象を絞り込んだのか、手動で値を補ったのかを区別します。再試行で得た観測は、元の予定時刻の値ではなく、再試行時点の値です。したがって、成功を上書きするのではなく、新しい実行IDと観測時刻を持つ履歴として保存し、レポート側でどちらを採用したかを明示します。
価格差ではなく、条件付きの変化として差分を読む
履歴を使う際は、前回との差額だけを変更検知の条件にすると、比較できない変化まで同列に扱ってしまいます。まず同じ市場、ASIN、利用可能な出品者文脈、状態、フルフィルメントという比較条件が維持されているかを確認します。そのうえで商品代金、送料、配送文言、Buy Boxに関する表示など、変化した項目を個別に記録します。条件が変わった行は「価格改定」とせず、「比較条件が変化」として別の確認対象にします。
実装では、比較の基準となった二つの観測IDを差分行に残すと便利です。たとえば、前回と今回のobserved_at、比較に使った品質状態、変化した原値、正規化値を並べれば、利用者は通知の根拠を確認できます。送料が前回は不明で今回だけ数値化できた場合、合計相当額の差を価格上昇と数えない、といった規則もこの層で適用します。数値が計算できることと、同条件で比較できることは別です。
変化なしの記録にも意味があります。同じASINが入力マニフェストにあり、同じ比較条件のオファーが観測され、必要な項目が満たされていることを履歴として残せば、単にデータが更新されなかった場合と区別できます。ただし、オファーが見えなかったことを在庫切れや出品停止の確定証拠にはしません。公開観測で確認できなかったという事実と、業務上の解釈は分けて報告します。
バイヤーと販売側で、同じ元データに異なる確認規則を重ねる
共通のオファースナップショットを持つと、組織内で別々のデータを作る必要はありません。ただし、利用目的ごとのビューと判断規則は分けます。バイヤー向けのビューでは、公開条件を比較できるか、仕入れ調査の追加確認が必要かを見せます。販売側のビューでは、同状態・同程度の配送条件として比較可能なオファーか、フルフィルメントや出品者文脈が異なるため単純比較を避けるべきかを見せます。どちらのビューも、元の観測IDへ戻れるようにします。
権限や責任の境界も実務上は有効です。収集・マッピング担当者は、元値を改変せず、変換規則と品質状態を管理します。業務担当者は、確認待ちの行を見て次の調査や価格レビューが必要かを判断します。この分担なら、データ処理側が価格決定を暗黙に行うことも、業務側が由来の不明な数値を前提に結論を出すことも避けやすくなります。
チーム間で共有するデータ辞書には、各列の定義、空欄とnullの違い、正規化規則、比較から除外する条件、品質状態の意味を載せます。たとえば空の送料欄が「送料なし」なのか「取得できなかった」のかを区別できなければ、同じ表を見ても結論が一致しません。データ辞書は一度作って終わりではなく、パイロットで新しい表示パターンや例外が見つかるたびに版を更新します。
証跡を保管し、公開スナップショットの限界をレポートに残す
公開オファーの比較では、結果表と同じくらい証跡の所在が重要です。各正規化行から、入力ASIN、実行ID、観測時刻、元レスポンス参照、適用したマッピング規則の版へたどれるようにします。原値が後から訂正された場合も、何がいつどの理由で変わったかを履歴に残します。これにより、週次レポートの数字に質問が出たとき、担当者の記憶ではなく保存された観測と規則に基づいて確認できます。
一方で、保存した履歴が市場の完全な時系列を意味するわけではありません。実行の間に変わった価格、表示されなかったオファー、閲覧条件に依存する配送情報などは、スナップショットだけでは網羅できません。レポートの注記では、対象市場、観測窓、対象ASIN、欠損件数、品質状態の内訳を示し、公開情報の限定された観測であることを明確にします。こうした注記はデータの価値を下げるのではなく、適切な利用範囲を守ります。
保管期間とアクセス範囲も、社内の運用ルールに合わせて定めます。必要なのは、各行の出所を検証できる期間にわたり、最小限の証跡を安全に保持することです。共有用の表には不要な元データを広く配布せず、必要な担当者だけが詳細へ戻れる設計にします。定期収集の成果は、価格の数字そのものだけでなく、どの数字がどの条件と時点に結び付くかを説明できることにあります。
比較ビューでは、判断用の列と証跡用の列を併記する
利用者に渡す最終表は、単なる順位表ではなく、確認可能なデータセットにします。表示用にはASIN、商品名、出品者表示、状態、商品代金、送料、フルフィルメント、配送文言、観測時刻、品質状態を置きます。確認用には実行ID、元値、元レスポンス参照、正規化規則の版、品質理由を別列または詳細ビューに用意します。判断を急ぐ利用者には要点が見え、調査が必要になったときには根拠へ戻れます。
比較ロジックも用途別に明文化します。販売側が競合を確認する場合、たとえば同じ状態かつ必要な配送条件が確認できるオファーだけを比較候補にする、と定義できます。バイヤーが調達調査の手掛かりを見る場合は、比較候補のほかに、条件不足で確認が必要な行を明示します。どちらも表示順位を収益性、需要、販売可能性の予測へ読み替えません。公開の一時点データは、次の人手確認を効率化する材料です。
履歴が蓄積した後も、変化の説明は慎重に行います。同じキーの観測で商品代金が変わったときは「表示された商品代金が変化した」と表現できます。しかし、送料、状態、出品者、フルフィルメント、配送文言が変わっていれば、同一条件の価格改定とは言い切れません。差分検出では、金額差だけでなく条件差を同時にフラグし、分析者が比較可能な変化かを判断できるようにします。
小さな運用ループを作り、拡大は検証後に行う
- 質問を固定します。競合条件の確認、仕入れ調査、カタログ運用など、今回の利用目的を一つに絞ります。
- 少数のASINを凍結します。市場、商品文脈、バリエーション規則、除外条件を入力台帳に残します。
- 商品とオファーを別々に観測します。レスポンス種別、実行ID、取得時刻を各記録に付けます。
- 原値を消さずにマッピングします。明確なものだけを正規化し、判断不能なものはunknownまたは確認待ちにします。
- 例外をレビューします。欠損、矛盾、重複候補を削除せず、品質理由とともにキューへ送ります。
- 測定してから頻度と対象を広げます。欠損率、例外率、確認時間を見て、定期実行の範囲を調整します。
開始後に追う品質指標を決める
運用を始めた後は、収集件数だけを成功指標にしません。入力マニフェストに対する処理済みASINの比率、オファー行のうちacceptedになった比率、incompleteとreview_neededの理由別件数、再試行率、実際の観測時刻と予定時刻の差を定期的に確認します。こうした指標は、価格水準ではなくデータセットが意思決定に使える状態かを測るためのものです。対象カテゴリや実行頻度を変えた際にも、品質が改善したのか、単に比較対象が変わったのかを見分けられます。
品質状態の内訳は、原因別に見ると改善につながります。たとえば送料の欠損が多いのか、出品者文脈が取得できない行が多いのか、価格表現の解析が曖昧な行が多いのかによって、見直すべきマッピング規則や比較ルールは異なります。確認待ちを減らすこと自体を目的にして、基準を緩めるべきではありません。比較可能性を損なわずに、どの例外を自動受理できるかを、原値を確認したうえで少しずつ決めます。
結論:Amazon.co.jp 出品価格データ連携を説明可能な運用にする
強いAmazon.co.jp 出品価格データ連携は、最も速く最安値を並べる仕組みではありません。出品者単位の公開条件、JPYの価格成分、送料、状態、フルフィルメント、配送表示、時刻、検証状態を残し、比較できない行を見える形で人へ戻す仕組みです。小規模パイロットから始め、商品とオファーの役割を分け、原値と証跡を保ったまま定期処理へ広げれば、公開スナップショットを過剰に解釈せず、バイヤーにも販売側にも使えるレビュー可能な基盤になります。
Start monitoring your competitors for free
Start Your Free Trial100 free credits, no credit card required.